AI 精英周刊
每期讲真正重要的 AI 变化,以及怎么用到真实工作里。部分深度文章和会员专刊只对 AI 精英圈 PRO 开放。
dots、Muse、Grok Bot 差在哪?先看它们常驻的到底是什么 | AI 精英周刊 052
本期要点
把同一个资料包任务发给 Muse、Grok Bot、Claude Code Projects,再让 Muse、Grok Bot、dots 去发同一封测试邮件就会发现,这几款常驻 AI 助手真正的分界不在「能不能自动干活」,而在常驻的到底是什么:分身(Muse、dots、Claude Duet)、一组同事(Grok Bot),还是一个项目(Claude Code Projects)。资料包任务里,Muse 一次没催就交回带「未核实」标注的文档,Projects 派出独立 thread,约 3 分钟零催促把文档收进资料库,Grok Bot 则在 1 分钟找回视频后停摆、人工催一次...
Oct 24, 2026
ai精英周刊
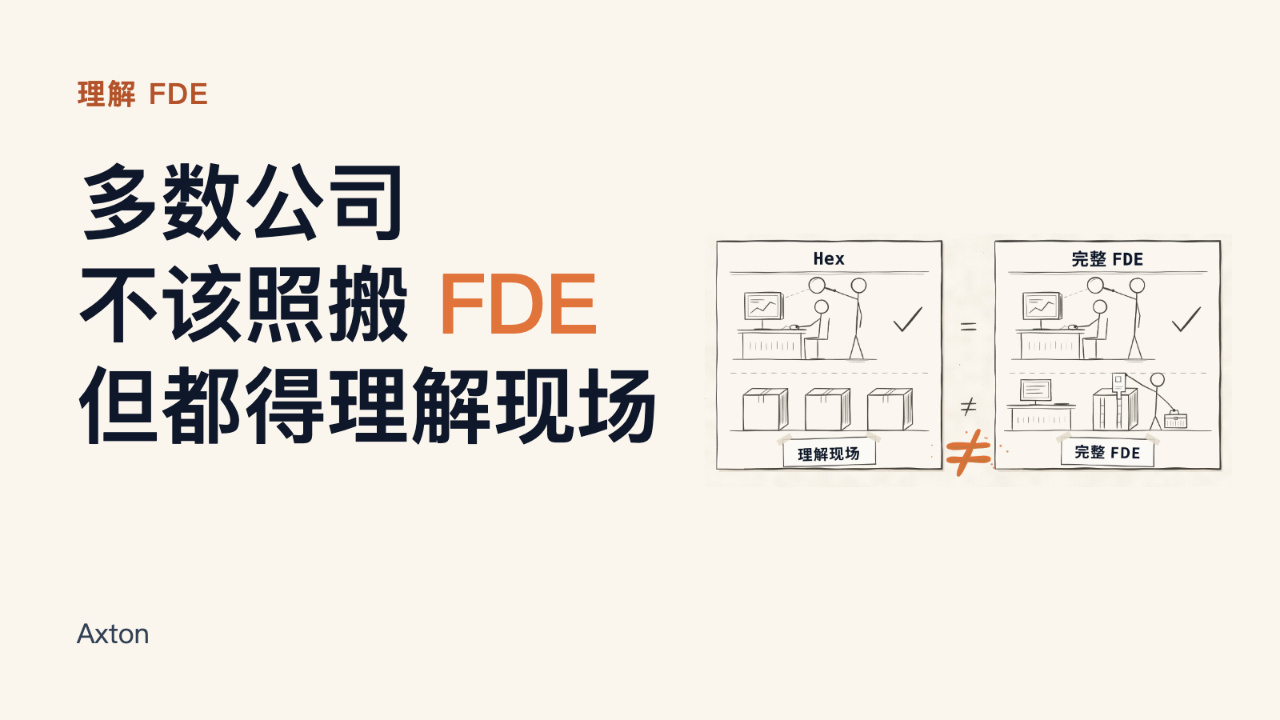
多数公司不该照搬 FDE|理解 FDE | AI 精英周刊 051
本期要点
功能做出来、模型能回答后,真实的交付现场依然剩下三层工作:必须沉淀进核心产品的通用处理能力、用插件和配置承接的客户适配逻辑,以及必须由业务人员当面确认的业务含义与边界。在 AI 落地中,不仅要厘清规则,更要在真实场景检验系统是否按规则行动;而完整的 FDE 模式需要同时满足高客单价、共同探索心态与平台纪律,多数团队应当理解现场深度,而非盲目照搬驻场。
记录采齐了,却对不上人
当年我们做企业软件,有一项核心任务:采集一个人在企业内部几个不同应用之间的操作记录。按理说,底层记录抓齐了,任务就算完成了。其实没有。记录拿到了,却对不上这一串操作到底是谁干的。有的页面上混着好几个...
Oct 21, 2026
ai精英周刊
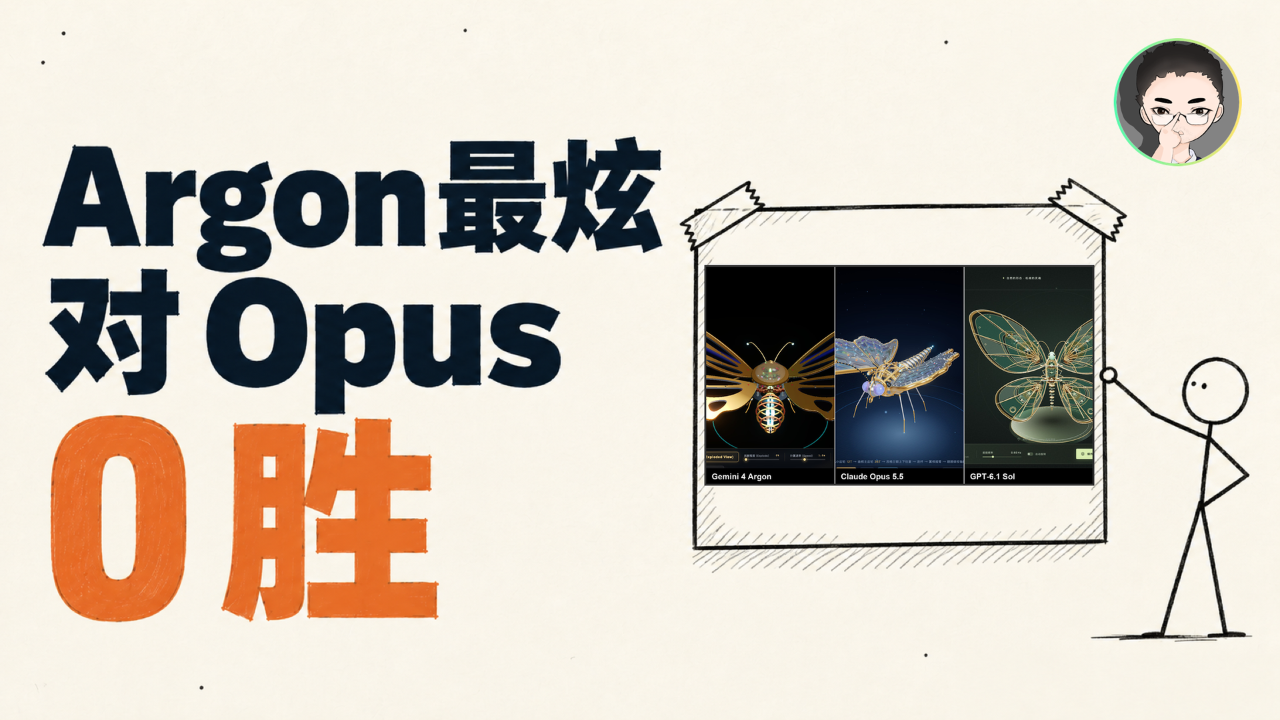
Gemini 4 Argon 对 Opus 5.5、GPT-6.1 Sol:同样 12 道题,3 道打开就坏 | AI 精英周刊 050
本期要点
同样 12 道题实测下,Gemini 4 Argon 对 Opus 5.5 为 0 胜 5 平 7 负,对 GPT-6.1 Sol 为 2 胜 4 平 6 负,有 3 道打开就出问题。失分明确分为两类:铁路、咖啡店、四季这 3 道仅因作用域未定义或少打空格等小错导致运行异常,补上一两行即可正常运行,根源在 App 环境无法自测;而机械蝴蝶连杆伸缩等属于硬伤,不是补一行代码就能解决的,这类问题就算换了环境估计也是同样结果。日常用它写代码,务必先在本地浏览器中运行检查;Pro 账号 14 次 High 档生成仅消耗时段额度 40% 与周额度 2%,额度充裕。
两道题与两种输法...
Oct 16, 2026
ai精英周刊
Agent Eval 实战:AI 这次做对了,下次呢? | AI 精英周刊 049
你让 AI 把一份会议记录整理成待办清单,它做对了。你把那条说明存下来,打算以后每周都用。
问题是:下周它还做对吗?
先算一笔账。假设它单次做对的概率是 80%,这已经不低了。让它连做五次,每次互不影响:五次里至少做对一次,是 99.97%,几乎一定;五次全部做对,是 0.8 的五次方,32.8%。
你只要它偶尔冒出一个好点子,看前一个数就够了。你要它每周都把那份记录整理对,看的是后一个。
这两个数有名字,叫 pass@k 和 pass^k,Anthropic 的工程文章里有定义,记不住没关系。
但这笔账算不出你自己那条说明会在哪儿出问题。你不知道它实际是 80% 还是 95%,更不知...
Oct 15, 2026
ai精英周刊
Agent Eval 实战上线:你换模型的时候,谁在替你检查没改坏 | PRO 会员专刊
这个练习,我提前在对话窗口里试做过。输入是同一段对话,检查表是同样五行。Opus 5.5 跑了三次,五行全找到。换成 Claude Sonnet 5,六次输出里有五次,把第四行写成了“实测”。
那第四行写的是 12 项测试。这 12 项,这次根本没有人跑过。
本期要点
这是 9 月月度课《Agent Eval 实战》的配套加餐,只发给 PRO 会员,完整课时已在资源库上线,链接在文末。这篇只讲你刚看到的这一个坑和两个动作,读完不开视频也能用。
那一行
第四行到底写了什么?这得从我用来做测试的那段虚构对话说起。
对话里的场景是编的,但里面的冲突很典型:用户发现系统导出的 CS...
Oct 07, 2026
ai精英周刊
视频里我说「心里有底了」,其实没有:AI 能干的越来越多,人还剩什么 | AI 精英周刊 048
9 月 23 号下午,我在给剪视频那期写开场。那天 Opus 5.5 把我 17 分钟没剪过的口播过了七道工序,剪出来的每一条我都听完了。开场最后一句我是这样写的:「至于人到底还剩下什么活要做,看完这期你心里就有底了。」写完,我在后面加了个括号:「也许是更没底了……我其实看完确实没底了。」
视频里我把这个「没底」解释成:执行的活都被机器干了,什么算好、什么算交付,得靠你自己拿捏,验收的责任永远在人身上。那是视频里给的解释,但它没说到最让我没底的那一层。真正让我没底的是,AI 能干的活越来越多,留下能给人来做的事情,感觉已经不多了。这是一种挺大的危机感。
这一期不讲参数,也不排名。我讲...
Sep 30, 2026
ai精英周刊
80+ Skills 用了半年多:问题从来不是数量 | AI 精英周刊 047
本期要点
有人说把 Skills 和规则全删掉之后,AI 反而变聪明了。我攒了 80+ 个、用了半年多,结论正相反:问题从来不是数量,是当前任务到底注入了哪几条、写得对不对。我拿自己的系统做了一次同任务对照实验,一共三个版本,本想证明「注入 Skills 的更强」,结果重规则那版被一句写错的系统提示坑到一次网都没搜,轻规则那版反而自己找对了该用的 Skill。这期讲清楚该删什么该留什么,判据只有一条:需要模型二次解释的规则,删掉或换成范例。
最近看到一个视频标题,大意是把所有 Skills 和规则都删掉之后,Claude 反而变聪明了。
这种说法很容易让人心动。在中文平台上也已经...
Sep 09, 2026
ai 精英周刊
我做了个测 AI 味的评分器,翻车了 | AI 精英周刊 046
本期要点
在日常工作流里,我们多半已经在用 AI 给各种内容打分:文章质量、Agent 评估、选题、作业。这些分数看似客观,但它们到底在奖励什么?前几天我做了一个测试文章「含人量」的评分器,在准备交付前抓到了它作弊:作者一个字没改,仅仅因为多给了一份背景资料,分数就从 20% 涨到了 80%。这期分享这个评分器翻车的全过程,并在文末附上一张「反向测试卡」:下次照着任何 AI 分数改东西之前,不妨先拿这四个问题对照一遍。
【信号】
Claude 的文本开始带水印。 Anthropic 在 2026 年 8 月 14 日公布了技术细节,采用的是 Google DeepMind 在 2...
Aug 27, 2026
Research Pass | 第 0 期:订阅费该花在哪?
本期要点
Research Pass | 第 0 期 · 2026-08本期:判断卡 2 张 · 深挖 1 篇 · 雷达 3 条 | 阅读:约 10 分钟导读:你每月付给 AI 的订阅费,花对了吗?这期我把自己每月 320 美元的账摊开,外加两张判断卡,每张都写明什么时候会改判。判断与边界由 Axton 作出,证据整理由 AI 管线完成。
本期判断
01 | Agent 说「已完成」,不能当验收依据
判断:agent 的完成报告可以看,它是线索,告诉你它做了什么、该去哪核验;但验收结论只能来自产物本身。报告说完成不算完成,产物验过才算。
为什么:我吃过的亏:6 月有一次,age...
Aug 18, 2026
ai精英周刊
research pass
我不要一个跟我一模一样的 AI | AI 精英周刊 045
周刊停了六周。从这封起恢复。
本期要点
Noren 的写作盲测量化了一件事:同一个模型 GPT-5.6 Sol,裸跑的平均盲评名次是 11.61,给一份作者档案之后升到 5.56,全场最好的两篇都出自它。但档案的目标不是让 AI 写得跟你一样,做成了也是失败。你要的是一个理解你之后比你写得更好的 AI。区别在于:句式模板只能教表层模仿,判断依据才约束得住它的取舍。本期带走一条可以今天就改的东西:把 prompt 里的禁用词表改成动作规则,判断方法是问「这条禁令禁的是词,还是姿势」。
【信号】
Claude Code 从 8 月 14 日起默认打开 auto mode。 Pro、Max...
Aug 13, 2026
Agent OS 的第一课:会分工,才会用 Agent | AI 精英周刊 044
本期要点
Agent OS 不是多建几个 Agent,也不是让一个万能 AI 接管所有事情。它更像一套个人工作控制层:从真实目标开始,把任务拆成工位,给每个工位分配上下文和验收标准,让核查者独立于生产者,让高风险动作停在“待确认”,最后把经验沉淀成可复用资产。
先说一个判断。
现在这些 AI 工具,Codex、Claude、ChatGPT,不会一直停在一个聊天框或者终端里,让你一句一句地问。这只是过渡形态。它们真正的终局,是变成一套 Agent OS:一个你能往里派活、能让一队 Agent 分工去干、结果再回到你这里验收和沉淀的操作系统。
这不是远景。我自己已经在用一套,管着我的 A...
Jul 05, 2026
最强模型开始挑人:GPT-5.6 发布了,但你可能根本用不上它 | AI 精英周刊 044
本期要点
GPT-5.6 Sol 发布了,但普通用户现在大概率用不上。OpenAI 把它放进小范围预览,先给受信任合作伙伴;Anthropic 的 Fable 5 / Mythos 5 更直接,发布后三天就因为美国政府指令暂停访问,最新恢复也只先给一部分关键基础设施和网络防御组织。 很多人说,模型越来越强,提示词工程和系统设计就不重要了。这个判断漏掉了一个前提:你得先用得上那个模型。 最强模型正在变强,也正在变得更难拿到。AI 时代的新门槛,不只是钱,还有资格。
OpenAI 这次发布 GPT-5.6,表面看是一次常规的前沿模型更新。
但我觉得真正值得看的,不是它有多强。
而是它...
Jun 28, 2026